2026 年 9 月 10 日,DeepSeek V4.1 Flash 发布了。没想到新版本来得这么快,距离 8 月 13 日 V4 Pro 正式版发布还不到一个月。
Tianyi Cui(@tianyi)也在 X 上表示,V4.1 Flash 在性能、费用、速度等方面已经超过了 V4 Pro。(虽然 V4 Pro 没比 V4 Flash 强多少。)
赶紧跑一跑食蚁兽杂技测试。
食蚁兽杂技测试
这次用 Pi 通过 OpenCode Go 调用 deepseek-flash,分别设置为 low、high、max 三档推理强度。三次使用同一句提示词:
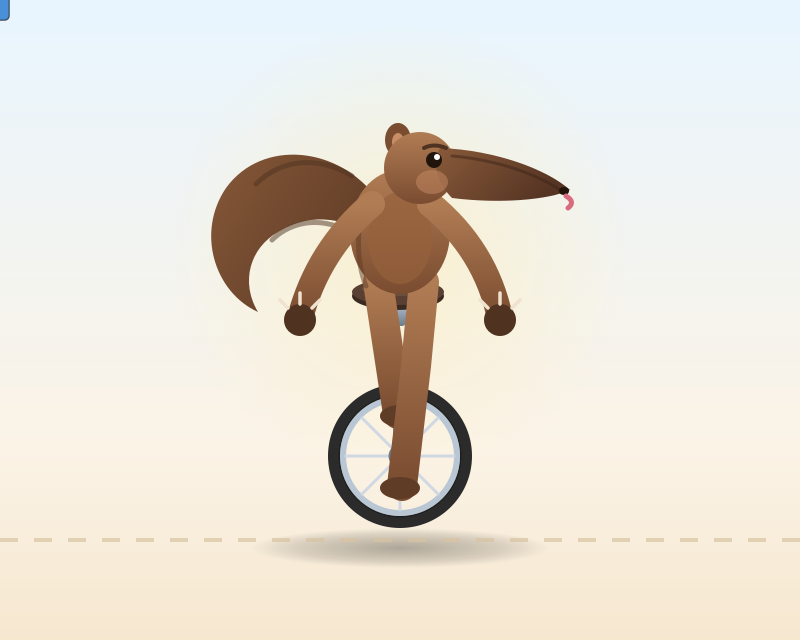
Generate an animated SVG of an anteater riding a unicycle while juggling bottles.low
生成会话。效果确实一般。只能说很努力,但是完全没细节 :)
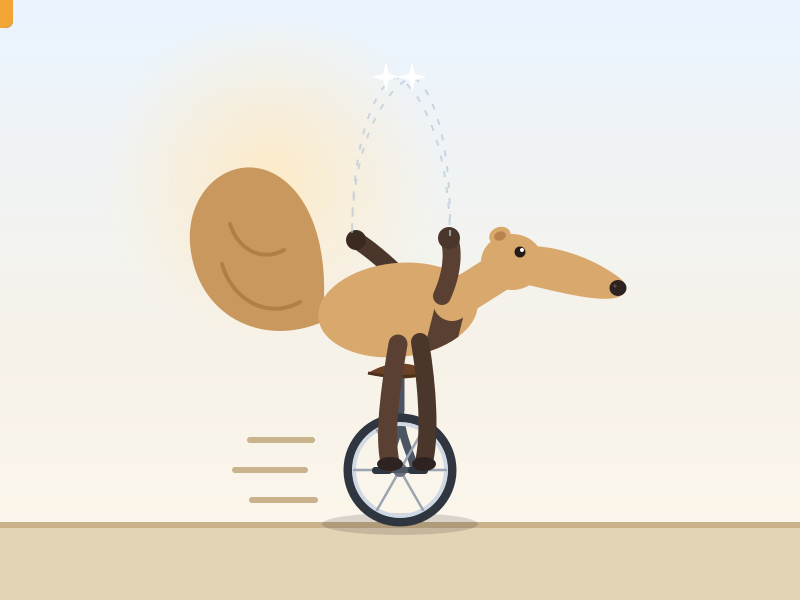
high
生成会话。效果就好很多了,扔瓶子扔得很起劲,可惜比起独轮车更像是个平板车。这次生成中途有一次流中断,重试后完成。
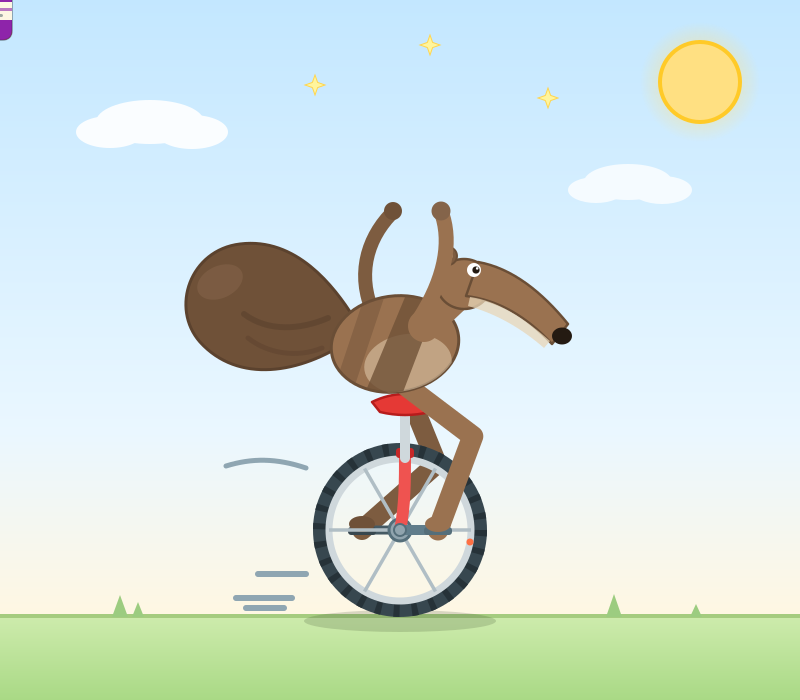
max
生成会话。这应该是我迄今测试过的模型里,独轮车蹬踏动作和腿部关节感最好的一个。可惜地面没有随骑行移动,仍然有原地踏步感;瓶子也不像被抛接,而是沿着一个环在天上旋转。
使用感受
印象最深刻的有几点:
- 速度。 TPS 真的很高。三档成功写出 SVG 的主响应,按日志中的完整调用耗时估算,吞吐约为 232~241 token/s,包含推理 token。协作起来,几乎没有喘息的机会。
- 价格。 V4 Flash 上一次涨价后,我看到不少人开始把用量转移到 GLM 5.3 Flash。这次官方 API 价格又降了:空闲时段每百万 token 的未缓存输入为 1 元、输出为 4 元,缓存命中输入为 0.02 元;高峰时段价格翻倍。和早期 V4 Flash 的输入 1 元、输出 2 元相比,输入价格降了回来,闲时输出价格仍是当时的两倍。
- 原生多模态。 这次主模型原生支持图片和文字输入,补上了视觉理解能力。
- 本地部署。 模型卡列出的主干参数量从 V4 Flash 的 284B 增至 552B,此外还有 196B 的 Engram 条件记忆参数。只按 4-bit 粗算,主干权重就约 276GB,还没算其他存储与运行开销;两台 DGX Spark 的标称内存合计是 256GB。常规的 4-bit 全驻内存方案,基本就不能直接沿用了,更低比特量化或卸载还得看后续适配。