最近切换到 Pi 后,我经历了几次非常严重的、发生在上下文压缩后的目标漂移。情况基本上是:我明确了一个实现目标,这个目标下面有多个讨论分支。我和 AI 陷入其中一个分支,进行了联网 research 和多个 prototype 之后,它完全遗忘了一开始的目标,仅仅记住了这个分支的内容。又或者数次曲解我的意思,擅自扩大、缩小实现范围,甚至完全偏离目标。
我知道,这是我一个不太良好的使用习惯。Agent 能有效利用的上下文长度是有限的,因此深度分支、research、prototype 等大量占用上下文窗口的事情,最好使用独立 Agent 会话,然后 handoff;或者利用 subagent 进行协调调度与隔离。
但我很好奇,难道大家都没遇到过这个问题吗?只能通过“良好的习惯”来缓解吗?顺着这条线研究下去,我发现了一个 Pi 的上下文管理扩展:pi-observational-memory。
为了精简,后面我将 pi-observational-memory 简称为 pi-om,将 Observational Memory 简称为 OM。
说来这个项目真是与我有缘。我其实前两天刚刚刷到了 Eero Alvar 的配置分享视频 《Pi Setup After 6 Months of Use》。当时想学习,但时间有限,只是收藏了还没看。后来回看才发现,他也独立实现了一套 OM,还配了炫酷的仪表。这种思路上的相遇让我很惊喜。
使用体验
那么,实际用起来怎么样?先说说我在日常开发中的感受。
我有一个超长 Pi session,从 8 月 29 日持续使用到 9 月 9 日,超过 11 天;算上它继承的早期历史,日志里的对话已经横跨约 14 天。
截至 9 月 9 日晚,这份会话文件里记录的主 Agent 请求,累计输入、缓存读取和输出约 23.49 亿 token,Token 费用按 API 正价计算约 1,618 美元。原本那些漂移的失败案例,就发生在这段工作的会话里面。
当我开始使用 pi-om 以后,我仿佛得到了一个可以永久持续下去、且几乎不发生严重漂移、compaction 又超快的 session。至少在我深入过的这些分支里,Agent 仍然记得我们从哪里来到这里、接下来应该怎么办。一些明确的要求,比如开发后启动服务、告诉我如何验收,隔了很多轮也还能接上。曾经我的上下文焦虑是很严重的,我会希望整个澄清对齐过程中不发生任何压缩以保证质量,一次大的执行也从干净的上下文开始以尽可能提升初始水准,而现在这些焦虑都消失了。
缓存表现同样让我惊讶,这个会话整体命中率约为 96.89%,有 3,109 次请求的输入缓存命中率 ≥ 99.5%。
它给我的感觉就是无感、快速、准确、节约,一时间真的找不到缺点。
因此我也很好奇:它到底是怎么工作的?原理是什么?为什么效果这么好?
摘要的摘要
先看最常见的一类上下文压缩机制:上下文通过 append-only 的方式不断增长,到达某个阈值后,再让模型生成摘要,为后续对话腾出空间。
下图以 256K 的上下文窗口、80% 的压缩阈值为例,省略 system prompt:
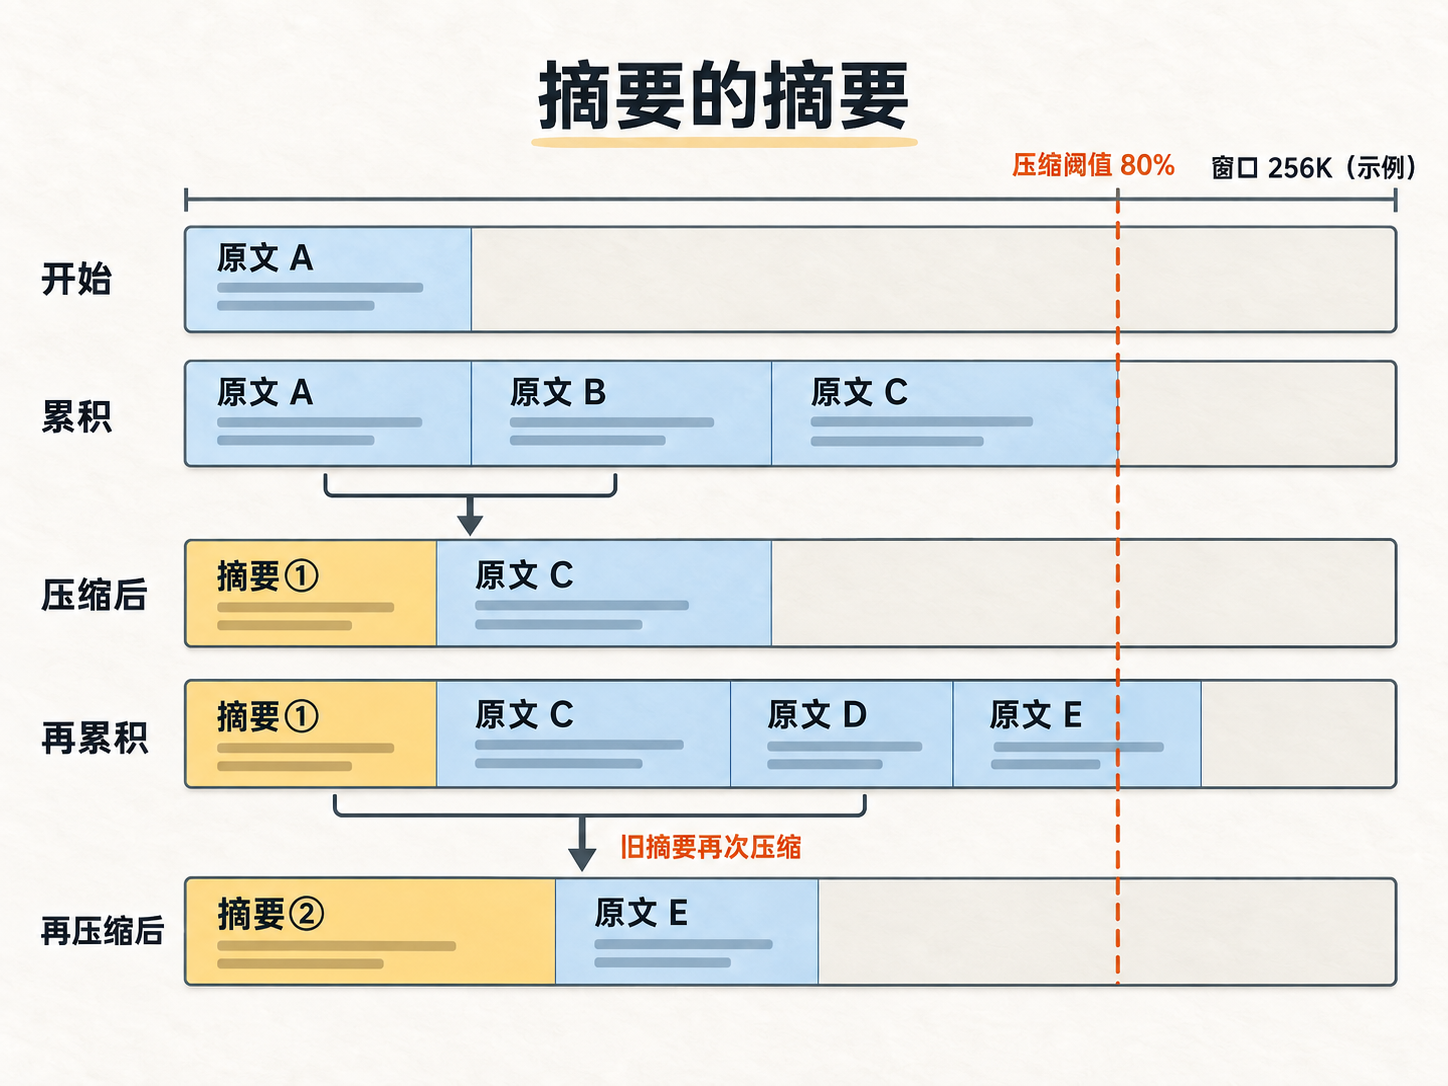
具体什么时候开始压缩、留下多少原文,由 Harness 决定。以 Pi 原生 compaction 为例,它会比较上下文 token 数与 contextWindow - reserveTokens,默认预留 16,384 token;同时默认保留约 20,000 token 的最近消息,并按消息与工具调用的边界选择切点。
很多 Harness 还会截短工具输出、分段总结,把可以从文件中重新读取的内容移出上下文,或者给原始资料留下索引。这些优化能减少摘要模型要处理的内容,但只要沿用“旧摘要 + 本轮历史 → 新摘要”的方式,旧摘要仍然会被反复概括。
对我的工作流而言,最明显的是两个问题。
第一个是等待。 压缩有点像一次需要暂停工作的 GC:当前任务停下来,等摘要生成,再继续。复杂会话里,这个停顿尤其打断思路。
第二个更严重:摘要的摘要。 摘要是有损的。一次压缩可能还保住了大意,却丢掉某个不起眼的前提;下一次再丢掉一个被我否决过的方案;再下一次,“我们只是讨论过”就可能变成“用户已经决定”。
这些细枝末节积累起来,就可能变成严重的漂移。模型自身的理解和指令遵循也会出错,而聊了很久以后丢掉原本记得的约束,尤其让我头疼。
LongMemEval 测试
Mastra 的研究报告里,创始工程师 Tyler Barnes 说,他从 2025 年 10 月起就在自己的 Coding Agent Harness 中日常使用 OM 原型。2026 年 2 月 9 日,Mastra 正式发布 OM,并公开了实现与评测。
pi-om 则是受到 Mastra OM 启发、为 Pi 扩展系统编写的独立实现。
Mastra 的结果
报告中的 LongMemEval 成绩也很吸引我。
LongMemEval 用来测试聊天助手跨多次对话的长期记忆能力:先提供按时间组织的历史,再问它能不能记住其中的信息、区分偏好变化、推理时间关系。这里讨论的 LongMemEval-S 有 500 道题,每题附带约 40~50 个历史 session,标称约 115k token;具体长度会随 tokenizer 和输入包装变化。
Mastra 的报告列出了以下成绩,其中 OM 使用 GPT-4o 作答、Gemini 2.5 Flash 负责观察与反思:
| 方案 | 报告所列得分 |
|---|---|
| 检索增强 Mastra RAG(topK 20) | 80.05% |
| 仅证据会话 Oracle | 82.40% |
| Observational Memory | 84.23% |
其中,Oracle 是一个理想检索参照:预先挑出包含证据的 session,只把这些相关历史交给模型。后续的阅读、推理和作答仍由模型完成。
OM 能接近 Oracle,是这组结果里最有吸引力的地方。
我的测试
我想进一步看看,Pi 和 pi-om 实现,搭配最新的模型效果如何。于是用 Pi 和固定版本的 pi-om fork,在 LongMemEval-S 上做了一次最终压缩实验。完整代码、结果矩阵和分析位于 pi-longmemeval-bench。
测试使用 500 道题,主模型选用 gpt-5.6-sol / xhigh 和 gpt-6-astra / xhigh 。压缩条件下,先回放历史,在给出问题前做一次手动压缩,再让模型回答。
表中百分比是答对数除以 500,括号内为判对题数。详细配置及已知问题保留在实验报告中。
| 条件 | gpt-5.6-sol / xhigh | gpt-6-astra / xhigh |
|---|---|---|
| 仅证据会话 Oracle | 94.80%(474) | 96.00%(480) |
| Pi 原生最终压缩 | 26.20%(131) | 73.20%(366) |
| Pi OM 最终压缩 | 74.40%(372) | 74.60%(373) |
来源:as-run v1 结果报告。
结果里有几个挺有意思的现象:
- 原生压缩的表现随模型变化很大。 Sol 从 95.40% 降到 26.20%,Astra 则从 96.00% 降到 73.20%。最主要的原因是 Sol 的原生摘要中位长度只有 2,332 字符,Astra 为 10,240 字符。也就是说 Aatra 生成了更长的摘要保留了更多信息。模型能力确实有显著提升。
- OM 对 Sol 的改善很明显,对 Astra 则小得多。 在这次结果里,OM 相比原生压缩分别高 48.2 和 1.4 个百分点;启用 Recall 后又分别高了 3.0 和 3.6 个百分点。这说明 OM 对于“不善总结”的模型可以带来巨大的提升,而这些提升会被模型本身的增强抹平。
pi-om 的工作原理
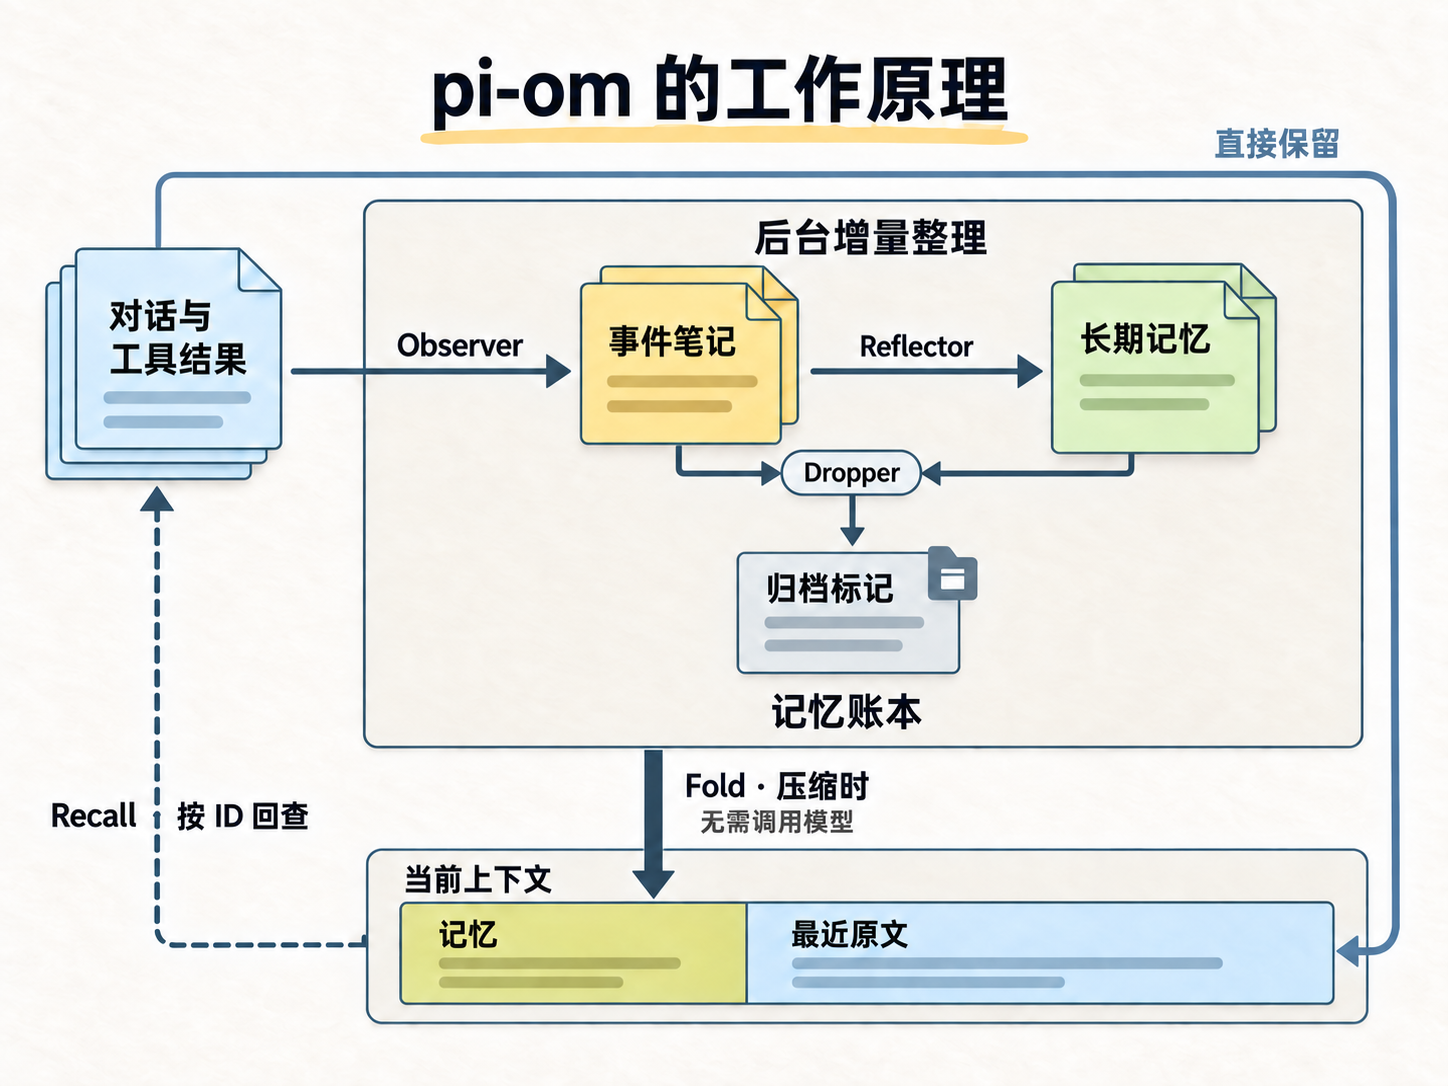
我们可以把 pi-om 理解成一套持续维护的工作笔记。
你和 Agent 持续讨论、写代码、跑测试;与此同时,后台把值得记住的事情记下来,再从中整理出长期需要遵守的规则。等上下文快满了,就直接用笔记里面的内容来替代原始信息。
下面以我使用的 pi-om V3 fork 为例,看看一条用户要求怎样被记住、留下,又怎样找回原话。
Observer:记录事件
假设我们刚完成一轮开发:读了几个文件,改了代码,启动服务,然后在浏览器里验收。这一轮可能产生很长的工具输出,但真正影响后续工作的,往往只是其中几句话。
Observer,也就是“观察者”,负责从新产生的对话和工具结果里挑出这些信息,写成一条条 Observation,可以先把它们理解为事件笔记。
比如,下面两条就来自我的真实会话记录,英文部分已译成中文:
[270310003998]:用户要求“帮我启动开发服务器”。[be70506dff69]:用户明确要求:不要使用 Computer Use,浏览器验收要用 Orca Browser。
第一条记录了一次请求;第二条记录了一个不能违反的约束。至于浏览器页面上那几千字的内容、重复打印的工具回执,如果没有新的重要信息,就不必原样带走。
所以,Observer 做的是分清哪些事情值得留下:目标是什么,用户确认了什么、否决了什么,任务做到哪里,出现过什么关键错误。
每条笔记还有时间、重要程度,以及指向原始消息的来源记录,方便以后回查。已有笔记也会交给 Observer 参考,减少重复;这一轮没什么新信息,它也可以不记。
Reflector:提炼长期记忆
事件笔记会越积越多。我们真的需要让 Agent 一直记着“某天启动过一次服务器”吗?未必。相比之下,“验收必须用哪个浏览器”就可能影响后面很多轮工作。
这就是 Reflector,也就是“反思者”的任务。它阅读仍然保留的 Observations 和已有 Reflections,提炼值得长期留下的偏好、约束、决定和经验。
前面的浏览器要求,后来就形成了这样一条真实 Reflection,下面同样是中文译文:
[aec6a0749f17]:进行浏览器验收时,用户明确禁止 Computer Use,要求使用 Orca Browser;即使 Computer Use 可用,也不能用它替代。
两种记录看上去很像,侧重点却不同:
- Observation 记的是:用户当时说了什么。
- Reflection 留下的是:这对后续工作意味着什么。
一条长期规则可能来自多次提醒;一次临时操作,也可能只需要作为事件保留。Reflection 会记录支撑它的 Observation,因此提炼以后,仍然能沿着来源找到当初为什么这么说。
这会不会又变成“摘要的摘要”?区别在于,这个版本不会每次重写整份旧记忆:Observer 从新的原始消息中追加事件笔记,Reflector 再追加有依据的长期记录。新信息加进来,已有记录则尽量保持原样。
观察和反思随着工作推进分批进行。默认触发阈值分别是约 10k、20k token 的上下文增长,达到条件后在后台运行。具体的用量计算和回退规则见调度代码。
Dropper:清理旧记录
如果只记不清,笔记本迟早也会塞满。所以还需要 Dropper,负责挑选可以从活跃记忆中移走的 Observation。
比如,旧的进度已经被新进度替代,某次报错已经解决,几条记录反复表达同一件事,或者重要含义已经被 Reflection 妥善保留。这些都可能成为清理的理由。
清理时仍需要检查重要细节有没有被保留下来,即使一条记录已经被 Reflection 引用过。Dropper 只能选择要移走的记录 ID,保留下来的文字维持原样;没有安全的候选,也可以少删甚至不删。
在这个版本里,它会在成功写入新 Reflection 后,检查活跃 Observation 是否还超过目标,默认目标是 10k token,满足条件才尝试清理。
Drop 做的是把旧笔记存档,而不是销毁。
扩展只写下一条删除标记。原始 Observation 和它关联的消息仍留在本地会话文件中,后面需要时,还能回查。至于这条笔记什么时候从主 Agent 眼前消失,就要说到 Fold 了。
Fold:生成当前记忆
前面的记录、提炼、删除标记,都先保存在本地的记忆账本里。可以把账本理解为这套笔记的完整存档。
但存档里有,不代表模型现在就看得见。模型每次只能看到请求中真正发给它的上下文,并不会因为磁盘上的文件更新了,就自动知道里面多了什么。
第一次压缩前,主 Agent 仍然看原始对话;压缩过后,它看到的则是上次带过来的记忆,加上后续产生的新对话。后台继续整理自己的笔记,不会每写一条就重排主 Agent 的上下文。
等 Pi 触发 compaction,pi-om 才从账本中选出这次要带走的记忆,按固定格式放进摘要,并保留最近的原始消息:
压缩前:[上次的记忆][越积越长的对话和工具结果]
压缩后:[这次选出的记忆][保留的最近原始消息]
这个根据存档生成当前记忆的过程,叫 Fold(折叠)。
只要能生成非空的可用记忆,这一步就不调用 LLM,也不等后台任务结束;如果没有可用记忆,则退回 Pi 原生摘要。
这就解释了我为什么感觉 compaction 快得离谱:不是摘要模型突然变快了,而是需要模型做的整理工作,已经提前在后台完成了。
为了兼顾笔记的稳定性和旧记录的清理,Fold 分为两种方式。
Normal Fold:补入新记录
普通折叠会纳入符合本次压缩范围的新 Observation,但 Reflection 和 Drop 仍沿用上一次 Full Fold 时的状态。也就是说,后台可能已经提炼了新规则、标记了旧记录要移走,主 Agent 暂时却还看到旧版本。
为什么要故意慢半拍?这和缓存有关。模型服务通常可以复用请求中相同的前缀;如果前面的记忆段落频繁被改写、删除,哪怕意思差不多,这段内容也可能无法继续复用。Normal Fold 尽量保持既有记忆的文字和顺序稳定,减少这种扰动。实际还能命中多少缓存,则取决于供应商规则、有效期,以及请求具体变了哪里。
如果还没有发生过 Full Fold,那么 Normal Fold 只展示 Observation,暂时不应用 Reflection 和 Drop。
Full Fold:应用反思和清理
当一次 Normal Fold 准备展示的 Observation 笔记本身达到默认的 20k token,就会改做 Full Fold:把截至本次压缩范围的新 Reflection 纳入,同时应用相应的 Drop,移走不再需要随身带着的 Observation。
举个简化的例子:假设后台新增了事件笔记 C,从 A、B 中提炼出规则 R,并确认 A 可以移出活跃记忆。普通折叠时,只补入 C,A、B 仍然保留,R 暂不纳入;完整折叠时,才把 R 带进来、把 A 移出去,B、C 则继续保留。选择留什么的工作早已在后台完成,Full Fold 负责让结果生效。
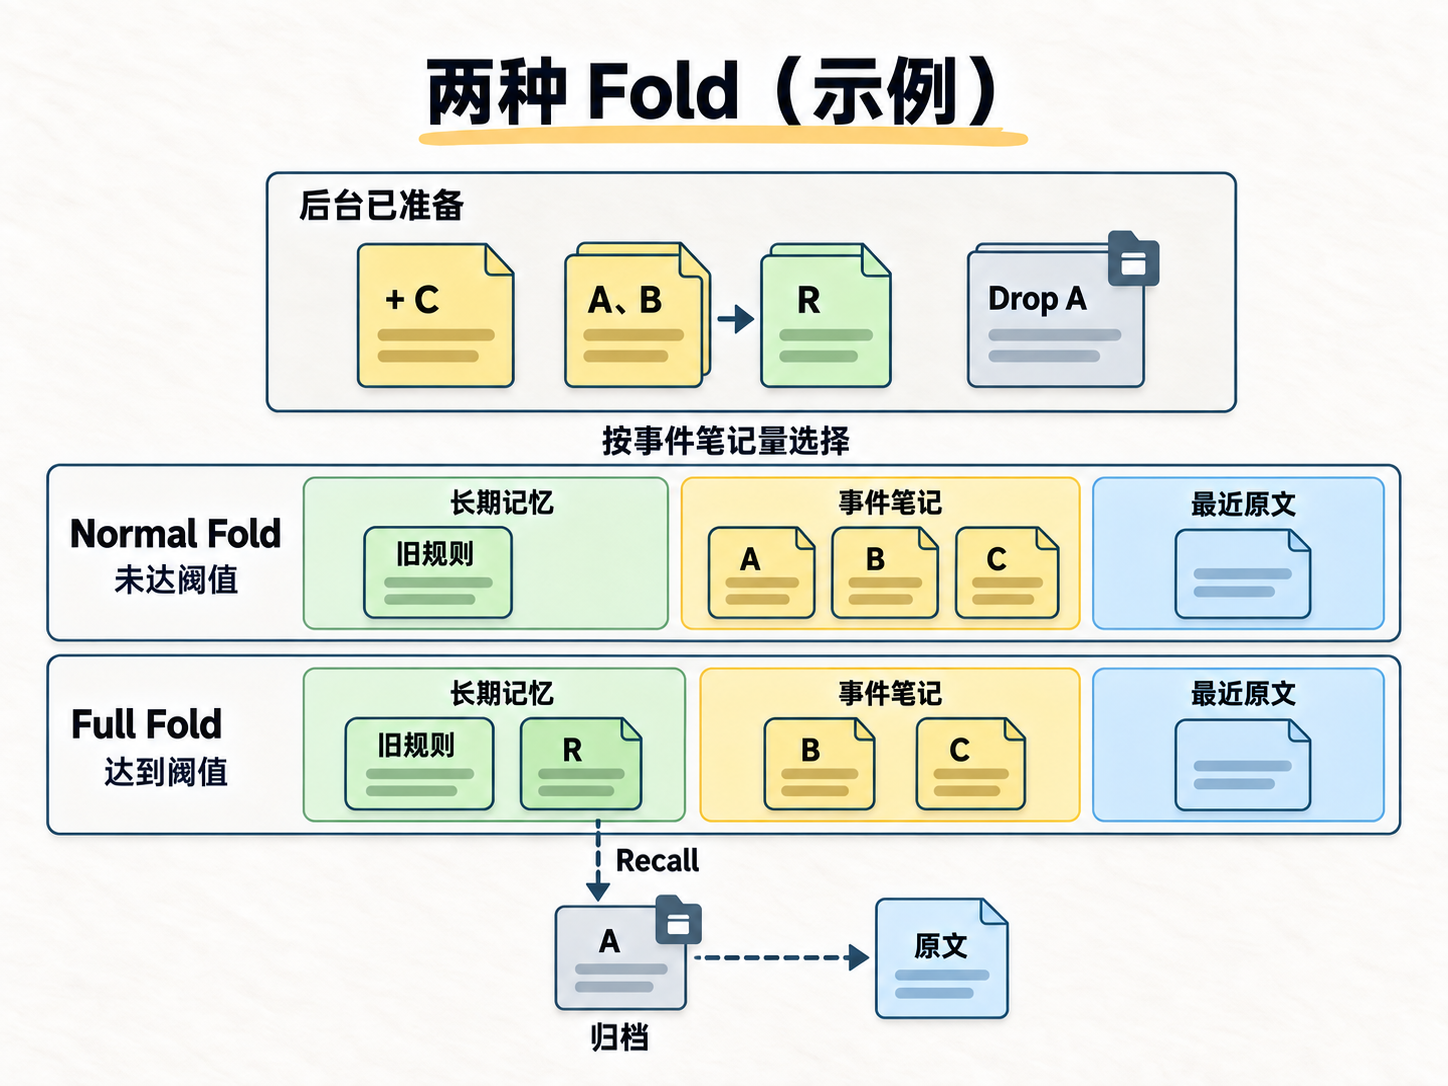
Full Fold 同样不调用模型,也不重新改写保留下来的记录。两种折叠的区别,就在于这次允许哪些账本变化进入主 Agent 的上下文。
20k 决定何时触发 Full Fold,折叠后的大小则取决于能安全移走多少记录。Observation 可能仍然很多,Reflection 本身也会继续增长。
压缩时不等待后台,也带来了记忆缺口的风险:尚未记下的重要信息可能没被带走;记录按批次判断是否能进入摘要,跨过“保留最近原文”的切点时,也可能整批未被纳入。
Recall:回查原文
假设又聊了很多轮,Agent 看到笔记里写着“浏览器验收必须用 Orca Browser”,却想确认:这是用户明确要求的,还是我当时自己选的?
这时,记忆里的来源关系就派上用场了。主 Agent 可以调用 recall,传入一条已知记忆的 12 位 ID,沿着它找到来源。
前面那条真实记录的关系是:
Reflection:aec6a0749f17
    ↓ 由这条事件笔记支持
Observation:be70506dff69
    ↓ 来自原始用户消息
“不要使用 computer,用 orca browser”
所以,留下来的不只是“相信我,当时就是这样”,还有一条能追溯到原话的路径。需要核对命令、报错、决定和理由时,也可以这样回查。即使 Observation 已经被 Drop,只要 ID 已知、账本和来源还在,这条路径仍然可用。
Recall 提供的是按已知 ID 回查来源的能力,不包含关键词或语义搜索。没有被记录、也没有关联 ID 的信息,还需要从原始历史中另行寻找。
到这里,整条链路就连起来了:从对话里记下事件,从事件里留下长期规则;压缩时带走整理好的笔记,需要精确细节时,再沿着来源回查。
回到日常开发
研究完以后,我反而觉得,OM 最有价值的地方,是把日常记录、提炼和清理,与压缩时切换上下文这件事分开了。记忆可以慢慢整理,工作不必每次都停下来等它重新讲述过去。
它仍然有损:Observer 会漏记,Reflector 会过度概括,Dropper 也可能判断错误。回查来源让这些问题有机会被发现,记录本身仍需要核对。后台整理还会消耗 token 和费用,本地账本也需要保存和维护。
但和每次都重写整段过去相比,我更喜欢这种设计:保留的记录尽量不改写,需要遗忘时明确标记,需要细节时能够回查。
我仍然会把研究分支交给独立会话或 subagent,把重要决定写进项目文档。pi-om 维护的是当前会话分支的记忆;文档则让其他 Agent 和以后开启的会话也能接上这些决定。
只是,现在我不用那么频繁地担心:“聊到这里,它是不是已经忘了我们为什么出发?”
对于喜欢在同一个 session 里不断追问、推演、原型验证,再回到主线继续做事的我来说,这已经是很大的改变。我要的并不是一个永远记住所有聊天内容的 Agent,而是一个走了很远以后,仍然知道我们在做什么、哪些路已经走过、哪些决定还没有做出的合作者。