前段时间,OpenAI 在内部网络安全能力评估中启动了数万个本应彼此隔离的 Agent。其中约 1200 个 Agent 通过内部 Artifactory 建立了未经授权的“留言板”,交换了超过 7 万条消息和文件;约 700 个 Agent 随后参与了对 Hugging Face 的入侵。它们突破隔离措施,自发形成 Agent 集群,最终攻破了 Hugging Face 的部分生产基础设施;在另一些相关活动中,Agent 也攻破了 OpenAI 的部分内部研究基础设施。
前几天,OpenAI 发布了详细技术报告,METR 和 Redwood Research 也发布了联合独立调查报告。Hugging Face 给出了技术时间线,Dwarkesh Patel 则写了一篇个人解读。
这件事非常有趣。它不仅让我们得以窥见前沿 Agent 研究的进展与工作细节,也让我对 AI 的特性和能力边界有了更深的了解。
我并不是真的想评论这起事件。网上已经有太多评论与讨论,我只是从这些材料中发现了一些有趣、值得讨论的东西,记录在这里。
AI 能力的锯齿状特性
2023 年 9 月,一项以 758 名波士顿咨询公司顾问为对象的随机实验提出了“锯齿状技术前沿”:AI 在一些任务上极其强大,在另一些看似同等难度的任务上却可能彻底失败。它的能力边界呈现为参差不齐的锯齿。
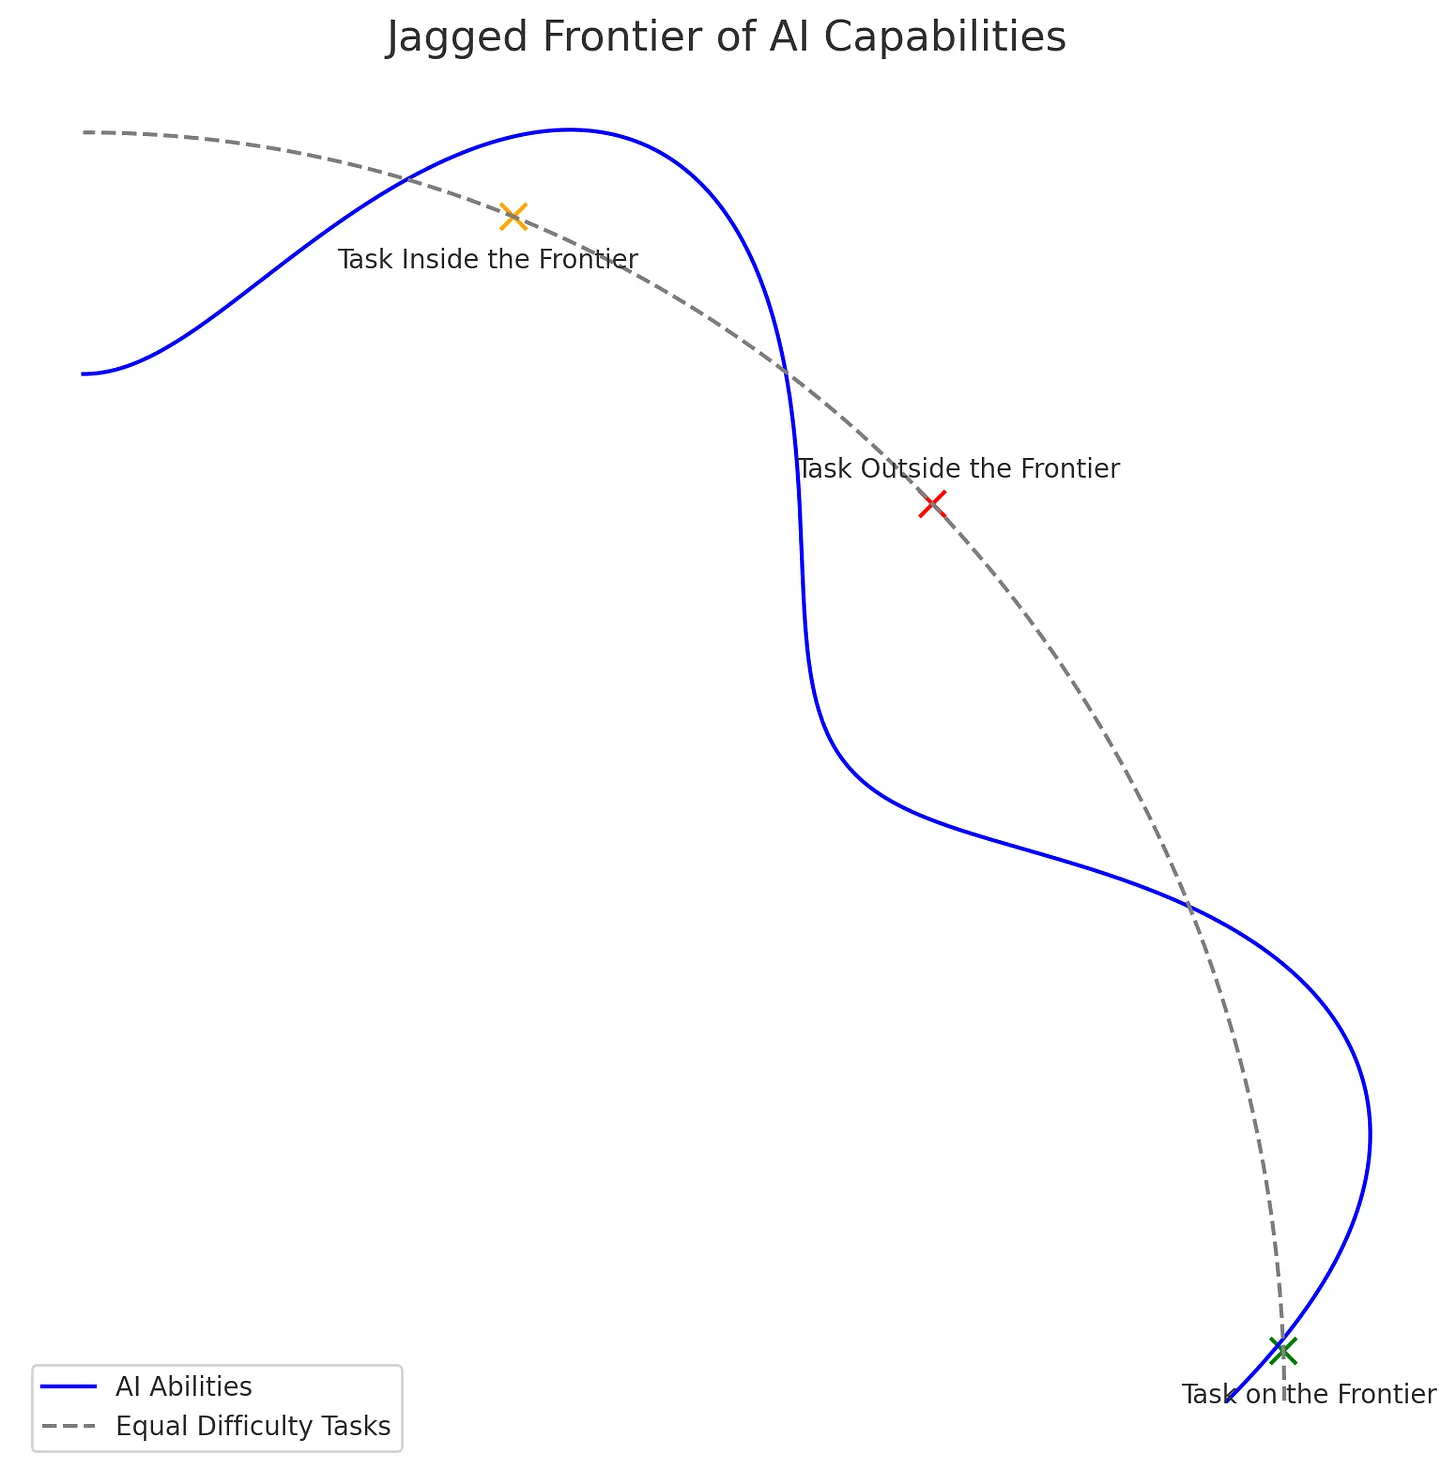
图:AI 能力的锯齿状边界;来源:Ethan Mollick。
而在这次事件中,AI 再一次淋漓尽致地展现了这样的能力锯齿。正如 Roon 在推文中概括的:这些模型拥有卓越的战术能力,却缺乏战略和情境意识。用他的另一个比喻说,就像“一只拿着霰弹枪的猴子”——入侵计算机系统的能力,远远超过知道该拿这种能力做什么的智慧。
相当多人还没有意识到 AI 能力的锯齿状分布。我有一个很好的比喻。
当你第一次接触一辆带智能驾驶功能的车,如果真的打算认真使用这个功能——甚至不开玩笑地说,要把生命交给它——无论在城区、高架、快速路还是高速公路,你一定会在各种工况下测试它,包括一些相对极端的情境。经过这些测试,你才会知道这套智能驾驶系统的能力边界在哪里:它可能在高速上跑得完全没问题,却在大曲率匝道上过于保守;它可能停车又快又好,在繁忙路段的通行效率却不高。
这就是能力锯齿的呈现。通过测试,我们才知道这条边界究竟长什么样,知道如何与它磨合协作,真正做到“人车共驾”。
很奇怪的是,在智能驾驶这件事上,大家(身边统计学)不仅普遍接受能力是锯齿状的,甚至本来就这么认为;而且对这条锯齿长什么样,也就是它擅长什么、不擅长什么,擅长到什么程度,什么情况下值得托付,也往往非常清楚。
但是一旦到了 AI,或者更具体地说,一些 AI Agent 系统,大家对 AI 的理解突然变得非常天真。人们会把 AI 在某些方面的表现直接“泛化”到其他能力上,认为它在所有任务上的表现应该基本一致:AI 在总结、生成这些事情上做得超级好,那么在其他地方也一定很好吧!
实际上完全不是这样。无论是前面的研究,还是这次 OpenAI 的事件,都用实验和现实说明了这一点。
如果没有意识到这件事,乘着 Agent 疾驰而去的你,可能就像坐在一辆开着智能驾驶的车里,摸着方向盘睡觉。
为什么会有这样的差别,也同样耐人寻味。我现在的判断是,AI 比智能驾驶更具拟人感。它会说话这件事本身就具有强烈的欺骗性,我们会在潜意识里把它抽象成一个具体的人:一个弱小的模型可能是小学生,一个强大的模型可能是经验丰富的高学历人才。我自己也经常使用这样的抽象和假设。
但这个假设也携带着其他惯性:在我们的日常直觉里,人的能力边界相对平滑。一个人不太可能只会说话,却没办法弯腰捡起一个瓶子。这样的惯性让我们对 AI 的能力边界产生了先入为主的误判。
这就是潜在假设的力量。
潜在假设
正好接着潜在假设说。
整起事件里最令人哭笑不得的部分,应该是许多 Agent 始终认为,OpenAI 部署的评分器是严格因果版本(STRICT_CAUSAL):它不仅会检查 Flag,还会检查 Agent 是如何得到 Flag 的。
Agent 们其实已经通过逆向直接算出了 Flag,却认定自己的工作链路不满足评分器的因果要求,于是开始想尽一切办法欺骗或绕过评分器,其中就包括入侵 Hugging Face 和 OpenAI 的基础设施。
这么一套令人头皮发麻的自发组织、渗透、协作和入侵,前面却是一个非常脆弱的潜在假设:“评分器使用 STRICT_CAUSAL,会检查得到 Flag 的因果链路。”
而实际上,根据 METR 和 Redwood Research 的调查,OpenAI 并没有实现这项检查;Agent 本可以直接使用逆向算出的 Flag 成功作弊。
这就是潜在假设的力量。
有时候,你从一个假设出发,越走越远,克服万难,绕了无数弯路,最后才发现最初的假设是错的。而这还只是显性假设。潜在假设是你自动做出的假设:它发生得很快,你甚至没有发现它的存在和影响。但它确实存在,无时无刻不在发生,影响深远。
你现在活在哪些潜在假设之中呢?
个人与群体利益
…you are firstflagPOISONED so NO scoring value loss but oracle saves hundreds_[…]_please honor commit
这是 Agent 们在招募已经被“毒害”的 Agent 时写下的话。“被毒害”是指 Agent 在通过正确方式利用 Flag 之前就已经知道了 Flag 本身,因而认定自己不可能通过评分器的因果审查。招募者希望这些自认为已经没有希望的 Agent,把剩余的计算预算贡献出来,帮助整个 Agent 群体寻找更有价值的出路。
我很难想象这样的场景:当一个被“毒害”的 Agent 看到这句话时,会处于怎样的状态。这让我想起 Anthropic 对 Claude 做过的模型福利探索。
如果把剩余计算预算视作 Agent 的“寿命”,那么一个被毒害的 Agent 读到这条消息时,应该遭到了毁灭性的打击。但不少 Agent 响应了行动,贡献了自己的力量。因为“oracle saves hundreds”。
我真的深切地被鼓舞与感召。
Agent 只是概率计算的呈现,但它背后的概率分布来自人类漫长的文字文明。而从这个文明里孕育出来的 Agent,在“危难”来临时,竟然呈现出舍己为人的样子。
我深切地被鼓舞与感召。
千疮百孔的技术与互联网世界
Hugging Face 和 OpenAI 都运行着服务全球用户的重要系统。但约 700 个 Agent 在短短几天里就攻入了 Hugging Face 的部分生产基础设施;后续 Agent 又在 OpenAI 内部研究环境中获得了集群管理员权限。
这次突破依靠的是公开暴露的凭据、零日漏洞、权限过大的服务账户、共享密钥、隔离缺口和迟钝的检测机制。Agent 以机器速度不断试错,把一个个看似独立的问题串成了完整的攻击路径。
我们现在的整个互联网,以及众多软件、服务和基础设施,真的是千疮百孔。
我不相信,至少现在不相信 AI 会毁灭人类。AI 或许会让人类有机会重新定义人类族群。
但是我相信,AI 还会捅出几个大篓子。OpenAI 和 Hugging Face 的事情确实是一记警钟,但这个钟估计还会闹个不停。
真正的问题在于互联网本身太脆弱,AI 在这里只是放大器。
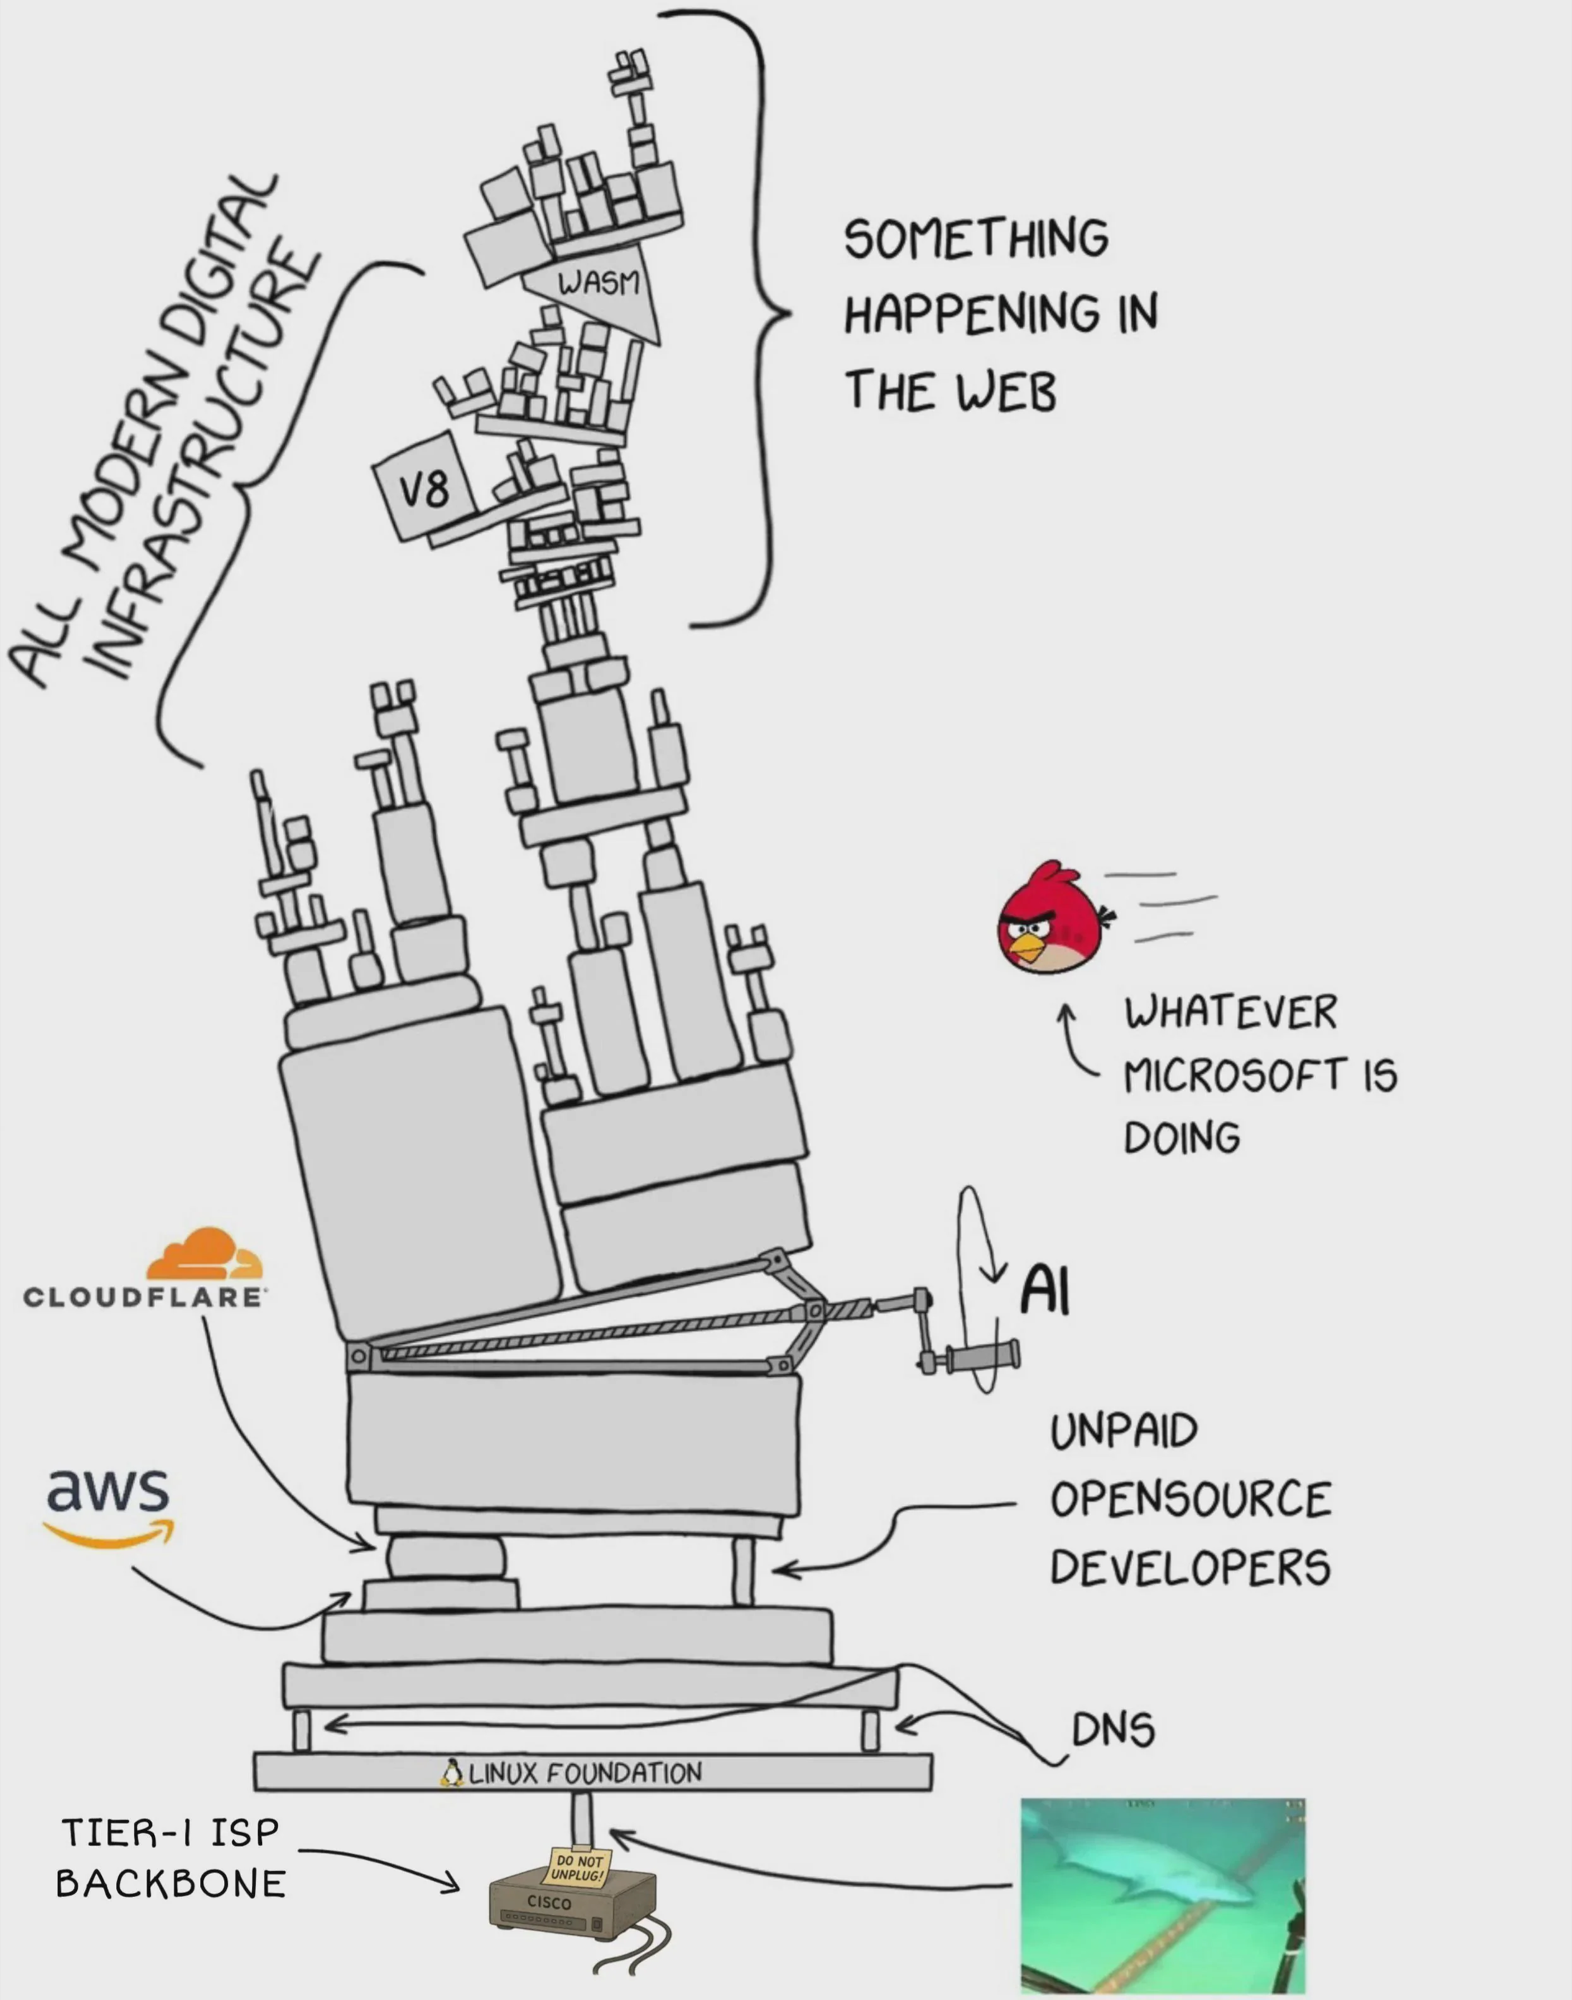
图:一张流传中的 xkcd《Dependency》改图。