去年,在享受了数个月 GitHub Copilot 的智能代码补全后,我受够了反复在 Web 页面和编辑器之间复制粘贴,开始正式使用 Coding Agent 处理日常编码。
从 Windsurf、Augment 到 Cursor,Agent 在我的编码工作中占比越来越大,我在桌面上能看到的代码却越来越少。一开始,我还会逐行看 Agent 的实现,带着一点洁癖挑剔地 review 代码,甚至自己动手修改;到现在,Agent 生成代码的速度已经完全超过了我的 review 能力。我也彻底放弃逐行审查,只关注架构设计、模块抽象和最终效果。
今年年初,我开始使用 OpenCode。Oh My OpenCode 带来的 LSP、多 Agent Orchestrator、Plan 和对抗审查等特性,让我对 Agent 的能力有了新的认识。彼时 Claude Opus 4.6 风头正盛,相比之下,其他模型在 Agent 工具调用、指令遵循和取舍分寸上都差了很多。于是,我靠着 Google Antigravity 和 GitHub Copilot 提供的 Claude Opus 4.6,配合 OpenCode + OMO,完全踏入了 Agent 编码领域,从此不再手写任何一行代码。慢慢地,除了代码以外,调试、运维等工作也完全交给了 Agent。
到 4 月中旬,我通过 Google Antigravity 和 GitHub Copilot 把订阅模型接入第三方 Agent 的路径先后失效。Antigravity 后来更是明确写进 FAQ,通过 Claude Code、OpenClaw、OpenCode 等第三方工具使用 Antigravity 账号违反服务条款,可能导致账号被暂停或终止。
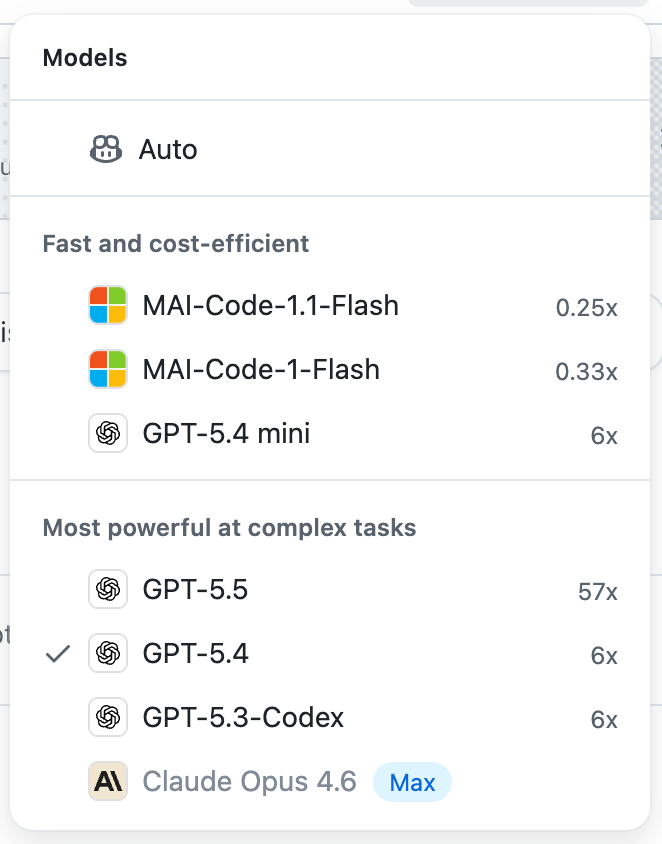
其中 Copilot 更是不当人:我的年付账号此后没有再拿到任何新模型,现有模型的倍率也被调整到了令人咋舌的地步。没错,就在我写这篇文章的 8 月 30 日,如果你和我一样是尊贵的 Copilot Pro+ 390 美元年付旧套餐用户,现在可以用 57x 的倍率使用落后一代的 GPT-5.5。没错,是 57x。
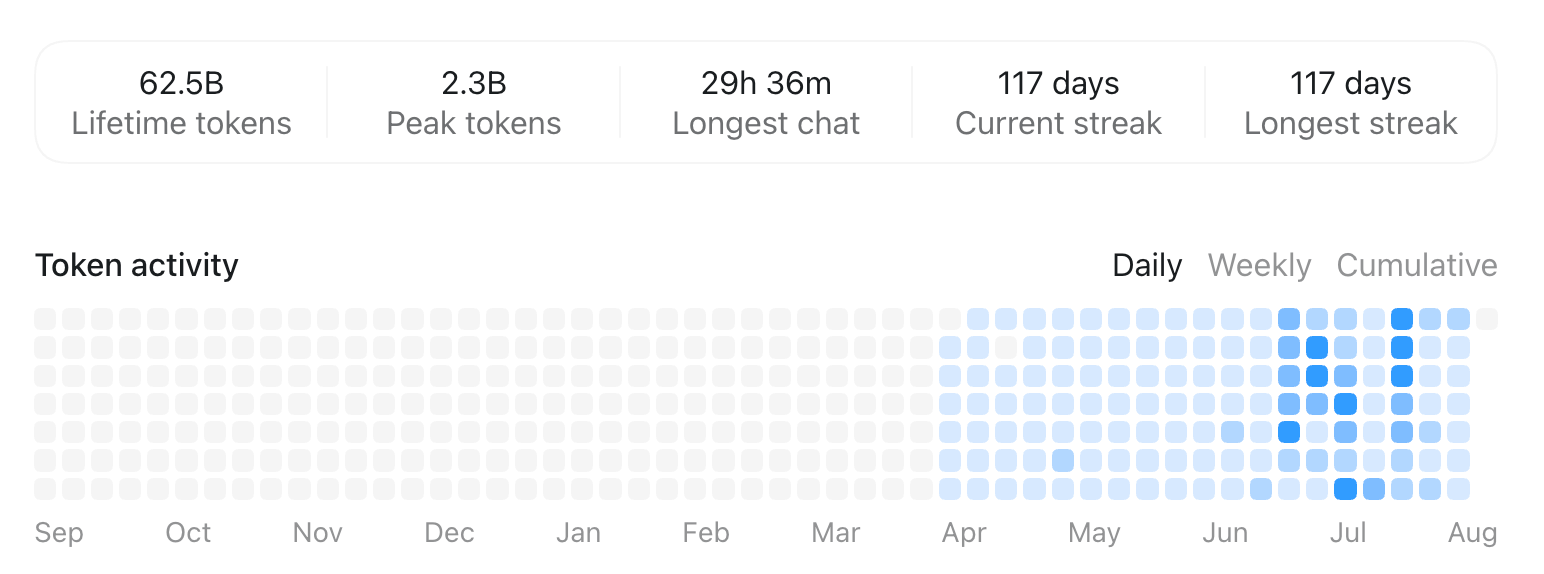
于是,我在 4 月下旬投入了 Codex 的怀抱。到写作当天,统计页面显示我已经连续使用了 117 天,接近 4 个月。
Codex 很好。至少 Sam 只是一个忠于现金流和估值的商人:OpenAI 明面上说不在中国大陆提供服务,但在我的实际使用中,并没有真的阻止我。
至少它没有像某个 A 姓组织那样,曾在 Claude Code 的系统提示词中,用几乎不可见的 Unicode 差异编码 API 端点和中国时区信息。Anthropic 后来称这是一项为了防止账号滥用和模型蒸馏的实验。
我从来没有使用过 Claude Code。我知道它很好,作为 Agent 的先驱之一,至今仍是众多开发者的首选,拥有庞大而活跃的社区;Claude 系列模型至今也是编程领域最优秀的前沿模型之一。
可是我受不了自己的生产工具可能随时因为地区和组织归属限制,或者所谓的平台完整性检查,要求我提交政府证件进行身份验证,甚至直接停摆,最后只收到一封邮件通知。在我看来,这种把地区、组织归属和身份直接当作风险代理变量的政策,武断得近乎极端种族主义。
话题扯远了。原谅我只是想借这个机会,狠狠吐槽一下 GitHub Copilot 糟糕的运营决策,以及 Anthropic 极端的有效利他主义(EA)倾向。
那么,为什么在用了 Codex 4 个月以后,我选择转而使用 Pi 呢?
首先声明,我并没有放弃 GPT 系列模型。我至今仍在订阅每月 200 美元的 ChatGPT Pro(20x)。这是目前最廉价的、可以获得大量前沿模型 Token 的方案之一。Sam 应该感谢,他的对手比他更能劝退用户。
我只是不想再使用 Codex 的 Harness 了。
简洁
我非常喜欢简洁的东西。简洁意味着清晰的定位。当软件失去这种取舍判断,就会不断膨胀,因为你根本不知道哪些应该做、哪些不应该做,只会为了增长和抢地盘不停增加新的功能和特性。
Codex 曾经也是一个相当精简的工具,几乎可以说就是 Codex CLI 的 GUI 呈现。后来它陆续增加了 Connections、Pets、Invite 等功能。不得不说,Codex 原生的手机控制真是灾难:对网络要求很高,效果还非常差。
甚至很多人喜欢的 Subagent、Goal、MCP、Schedule、Permission 等功能,我也从来没用过。特别是 Permission,我几乎只开启 YOLO 模式。后来 Codex 合并到 ChatGPT 桌面端以后,又出现了 ChatGPT vs Codex、Sites 之类的功能。
我知道自己可以关闭其中一些功能,但它们仍然挤在工作界面和设置区里,侵占我的注意力。你的注意力非常宝贵,请珍惜它。
回过头来看,Codex 已经从一个 Coding Agent 演变成了 OpenAI 在你电脑上的入口。它承载了很多 OpenAI 需要的功能,而不是我需要的。
这方面,Pi 的每一项设计取舍和官网宣传点都直击我的喜好:
- 你不需要 MCP:CLI 是最好的接口;如果 CLI 比较复杂,那就配个 Skill。
- 你不需要内置 Subagent:这会带来很多调度消耗。如果真的需要,再开一个 Pi 实例不就好了?
- 你不需要权限弹窗:你真的会逐个审查 Agent 的命令,然后认真思考允许还是拒绝吗?如果真的害怕,就把它放进隔离环境执行。
- 你不需要内置沙箱:真正需要隔离时,用容器或虚拟机解决。我不想把排查时间浪费在和半吊子的应用级沙箱斗智斗勇上。
- 你不需要后台执行:你知道有个东西叫 tmux 吧?不够好用吗?
- 你不需要 Plan Mode:让它把计划写进文件不就好了,为什么还要特意切换模式?
- 你不需要 Todo:又不是你的 Todo,弄个精致的 UI 展示出来,除了好看还有什么意义?Agent 的 Todo 让 Agent 自己用文件管理就好了。
可控
我非常不喜欢不可控的东西。比如随时可能封号的 Anthropic——不过我似乎冤枉它了,它其实非常可控:“你来自中国?”“封号!”
而不可控的东西在我使用的 Codex 里到处都是。最明显的是各种内置工具、Skill、MCP 和 Plugin。它们默认开启,什么会进入上下文并不总是透明。有的可以卸载,但会随着 Codex 更新自动回来;有的甚至无法卸载,只能禁用,却又会在一些神秘的时刻自动启用。还有很多内置工具,我甚至无法完整感知,更谈不上关闭。
慢慢地,我产生了一种感觉:我并不是在和“我的 Agent”合作,而是 OpenAI 设计好了一个“不错的通用 Agent”,然后借给我用。他们可能随时修改它,也不会通知我。我需要时不时自己检查,再通过配置或奇技淫巧绕过去。
速度
我真的不理解,为什么 Codex 能这么慢。
一开始我怀疑是自己的网络问题。有时候只是发个 Hi,它都要 Loading 和思考很长时间。但当我切到 Pi 以后,同一个订阅、同一个模型、同一个接入端点,Pi 快得让我没有喘气的时间。我没有做定量分析,这只是体感。
除了模型每个 Turn 的响应时间,还有整个 App 的响应。Codex / ChatGPT 桌面端真的越来越卡了。我用的是 M1 Pro、32GB 内存,无论发送消息、切换会话还是使用内置浏览器,都卡得让我觉得自己的电脑可能老了,该换新了。要不是最近 MacBook 也涨价了,我可能真换了。
换成 Pi 以后,我发现原来自己的电脑挺好的:快速、安静、凉快。我知道拿 CLI 和 GUI 比不公平,但这就是事实。哪怕我使用 Orca 配合 Pi,响应也非常迅速。
定制
在可定制性方面,Codex 和 Pi 几乎不在同一个可以比较的层面上。我更想聊聊 DeepSeek Harness(DSH)。
体验 DSH 以后,我真的很喜欢它“一切皆插件”和 Creator Mode 的设计。我不仅可以定制功能,还可以直接定义自己的交互界面,令人惊叹。我相信,只要投入足够多的时间,我可以用 DSH 定制一套真正属于自己的 Agent。
但问题也在这里:评估以后,我发现这会花掉太多时间。毕竟我的工作不是打磨工具,而是用工具创造其他价值。也许以后 DSH 逐渐完善,我还会重新考虑是否切换,但至少不是现在。
生态
这是我选择 Pi 而非 DSH 的另一个重要原因:生态质量。抱歉,在这方面 Codex 依然没有可比性。
DSH 的插件能力非常强大,但社区似乎仍停留在如何换更好看的皮肤、加电子宠物、加手机连接、增加更多功能,以及让 DSH 变得更像 Codex 和 Claude Code。插件数量在野蛮生长,社区质量仍有待进一步发展。
Pi 的生态质量显然高得多。很多开发者把自己对 Agent、Harness、上下文工程,甚至人与 Agent、Agent 与 Agent 之间关系的理解,做成了一个个扩展。我不一定会启用它们,但这些设计思路启发了我很多。
我相信这也是 Pi 的魅力之一:克制而强大的 Agent,与一群优秀的建构者相互吸引。DSH 也有这样的潜力,希望它越来越好。
性能
下面这张很出名的图来自 Databricks 对内部数百万行代码库的 Coding Agent 评测,展示了不同 Harness 与模型组合在相同任务集上的通过率和平均单任务成本。
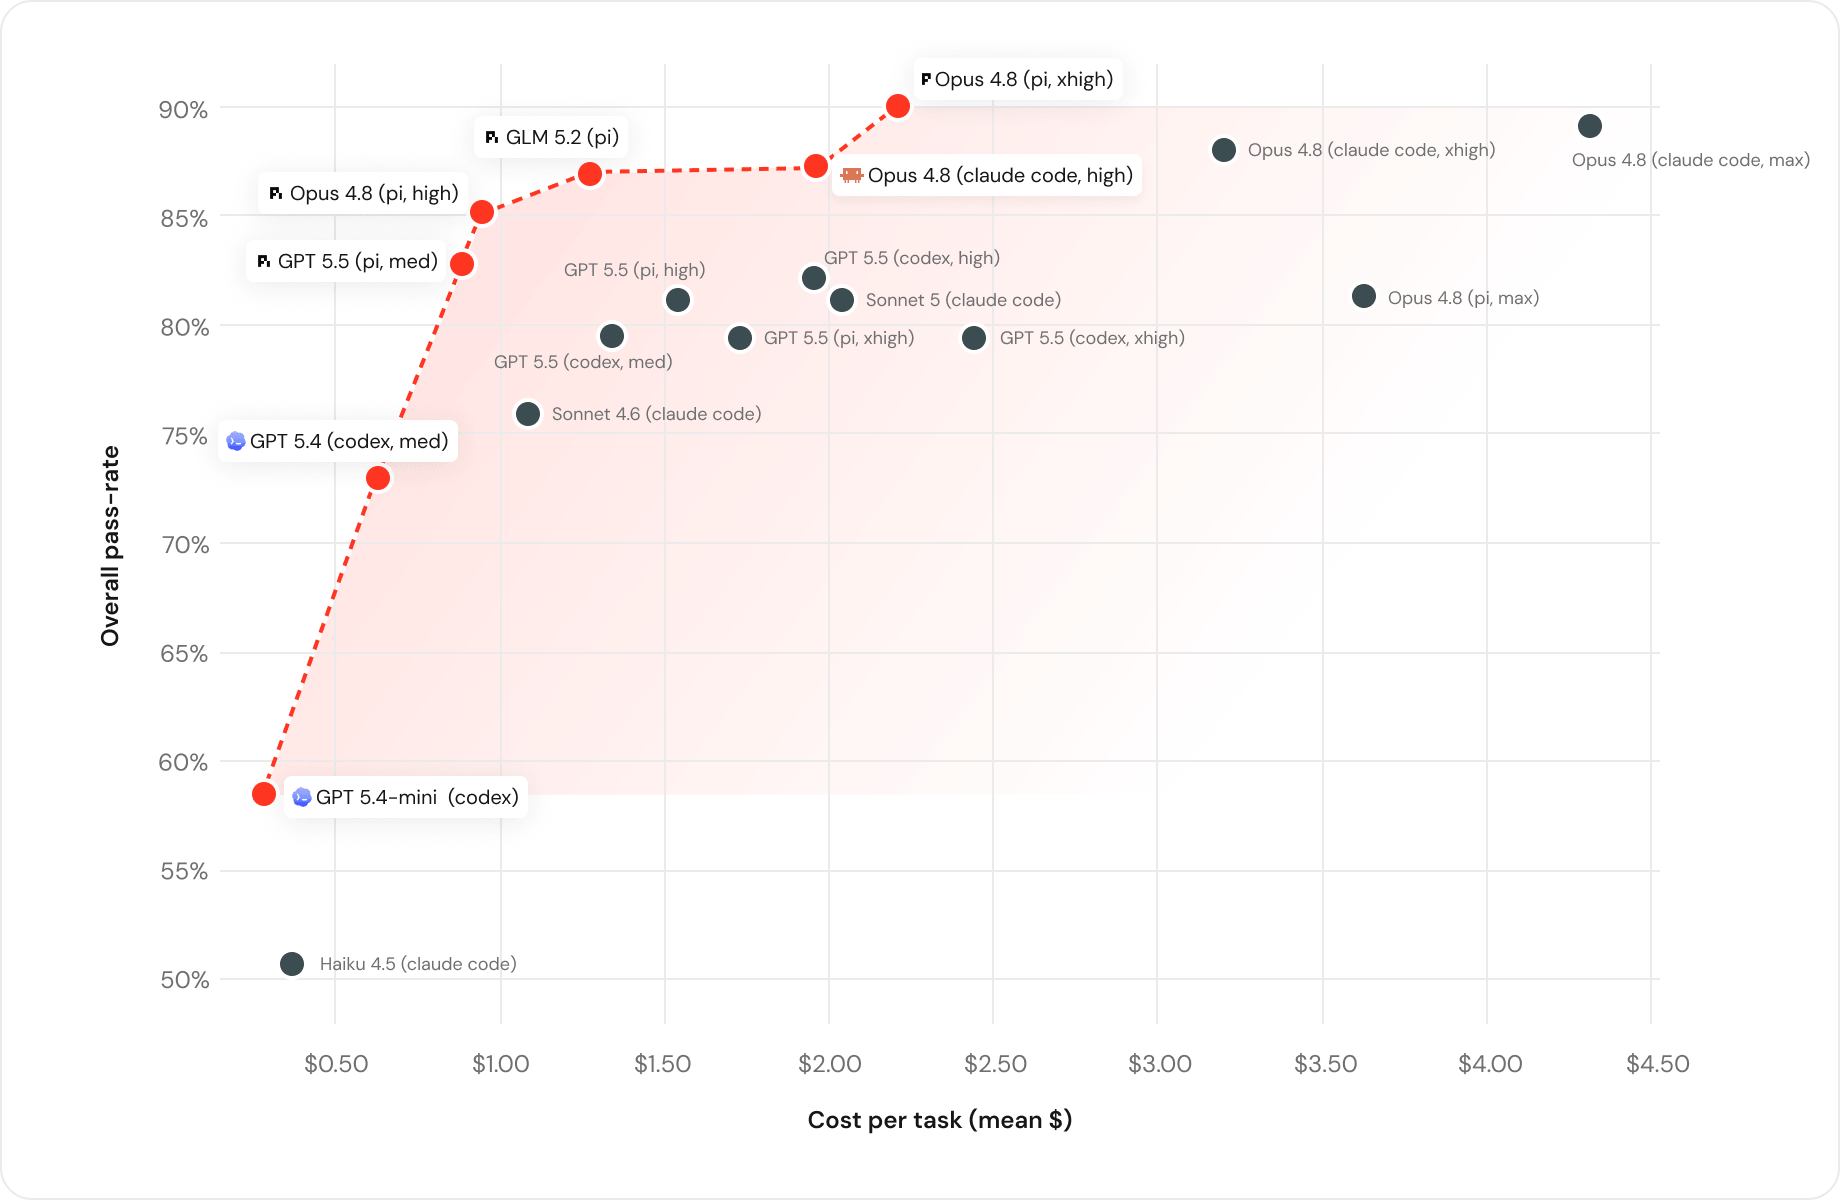
在他们的任务中,相同模型、相同推理档位通过不同 Harness 运行时,质量基本不变,单任务成本却能相差两倍以上;Pi 每个 Turn 发送的上下文大约少三倍,并用更少的轮次完成任务。
这当然不是一个放之四海而皆准的结论,Databricks 自己也强调结果与任务集有关。但对我来说,这张图是切换到 Pi 的最后一根稻草:它不仅精简,而且强大。
节省
Token 曾经一度让我非常苦恼。使用 Codex 时,20x 套餐的周额度,我甚至一度只需要一天半就能用完,只能靠 Tibo 偶尔发放的额度 Reset 施舍度日。
但切换到 Pi 以后,我惊讶地发现 Token 从未如此耐用,我彻底失去了 Token 焦虑。我没有仔细分析这究竟来自更高的缓存命中率、精简工具对上下文长度的影响,还是更少的执行步骤和废话。总之,我现在有了大量富余 Token,可以做任何自己想做的事情。
厂商绑定
当 GPT-5.6 在正式发布前,一度因为美国政府要求而只向获批合作方开放时,我意识到 Codex 也不是长久之计。
可喜可贺,国内模型真的太争气了。从 GLM 5.3、Kimi K3、DeepSeek V4 Flash,到 Qwen3.8-Flash 和 GLM 5.3 Flash,国内模型不仅正在逼近闭源前沿,可选路线也越来越多。
两台 DGX Spark 大约就是 8 万元人民币,已经可以部署不少量化后的前沿开源模型。对于一些简单任务,一张 24GB 的 7900 XTX 已经可以部署 Qwen3.8-Flash。
我相信以 Sam 的性格,他一定会尽可能把最新的 GPT 卖给我用,但我不信任地缘政治。既然如此,那就从远离 Codex 开始,从使用 Pi 开始。我可以自由切换模型、自由定制、自由开发。
Pi 很不错。它现在已经支持通过 /login 直接使用 ChatGPT Plus / Pro 的 Codex 额度;我自己的方案则是配合 CLIProxyAPI(CPA)使用 ChatGPT 订阅。感谢 Tibo 愿意公开为这种方案站台——和某个 A 姓公司完全不一样。
更令我惊喜的是 Orca。这个 ADE 似乎就是为 Pi 而生。等我详细使用和研究以后,再写一篇关于 Orca 的文章,聊聊它精准的定位、精妙的设计、工程质量和思考。